Dette indlæg [4:4] er en del af en serie af GPowers systemingeniør, Jesper Kjær Sørensen, om at bygge solide software- og testsystemer.
Når en fejl opstår i et testsystem, bør operatøren sjældent være den, der skal beslutte, hvad der nu skal ske. Hvis operatøren ofte mødes af en dialogboks med valget mellem fx Retry, Ignore eller Abort, har du i praksis flyttet en del af fejlhåndteringen fra systemet og ud til operatøren.
Over tid lærer operatøren, hvilke fejl der kan ignoreres, hvornår testen skal genstartes, og hvornår nogen fra udvikling skal tilkaldes. Det virker måske fint, men det er i virkeligheden fejlhåndtering nede hos Tekniker-Mads i produktionen.
I denne artikel ser vi på, hvordan TestStand kan bruges til at forebygge og håndtere fejl, så det er testsystemet – og ikke operatøren – der tager sig af dem.
Der er forskel på fejl…
1) Sikkerhedsfejl
Ved sikkerhedsfejl er der ikke andet at gøre end at bringe testsystemet til en sikker tilstand. Dette skal helst være håndteret af dit sikkerhedssystem, som monitorerer dit testsystem. Disse sikkerhedsfejl er der, hvor der kan opstå personfare, og det skal ikke blandes sammen med dit testsystems eksekvering.
2) Systemfejl
I artiklen fokuseres der hovedsageligt på systemfejl under drift, som detekteres og repræsenteres i TestStand som en ”Runtime Error”. Disse systemfejl eller driftsfejl er ikke det samme som produktfejl, og må heller ikke sidestilles. Der er tale om en fejl, der påvirker testsystemets evne til at udføre testen, og dette må ikke resultere i et fejlet produkt. Hvis en strømforsyning i testsystemet ikke leverer den korrekte spænding til produktet, er der tale om en driftsforstyrrelse eller en systemfejl, som oftest manifesterer sig ved en række af produkter, som fejler på samme tester.
3) Produktfejl
Produktfejl derimod er, når produktet ikke lever op til de krav, som stilles til produktet. Produktfejl kan f.eks. være, at produktet skal levere en spænding mellem 11 og 12VDC, og den så leverer 10,5VDC. Dette er udenfor det specificerede spændingsområde, og dermed fejler produktet.
Kilder til uhåndterede systemfejl
Systemfejl kan opstå både som fejl i udviklingen af testsystemet og som fejl i de ressourcer som en test afhænger af. Et eksempel på en systemfejl fra udviklingen af et testsystem kan være, at en udvikler kopierer nogle steps fra en testsekvens til en anden, og glemmer at oprette de variabler, der bruges i den nye sekvens. Disse typer af trivielle fejl kan man fange med TestStands sekvensanalyseværktøj (Læs mere om sekvensanalyseværktøjet her). Den udfører en statisk sekvensanalyse men kan ikke tjekke dynamisk oprettede udtryk.
En alternativ kilde kan være, at udvikleren arbejder på testsekvensen uden at kunne teste sine rettelser iterativt, fordi testsystemet ikke er funktionelt. Dertil kommer udviklerens antagelser om specifikke tilstande for en Device Under Test (DUT), såsom oprettelse og vedligehold af netværksforbindelser eller manglende .
Kodemodulerne er en kendt kilde til uhåndterede systemfejl. Eller rettere i grænsefladen mellem kodemodulerne og testsekvensen. Dette er ikke specifikt for LabVIEW kodemoduler, men lad os bruge det som et grundlæggende eksempel. I LabVIEW-kode er det ofte meget normalt, at man har et ud af ens VI, hvis en fejl sker. Grundet TestStands LabVIEW-adapter bliver en fejl, rapporteret via error og derfra til TestStands fejlhåndtering inklusiv de respektive callbacks, som kan konfigureres, som er illustreret på figur 1.
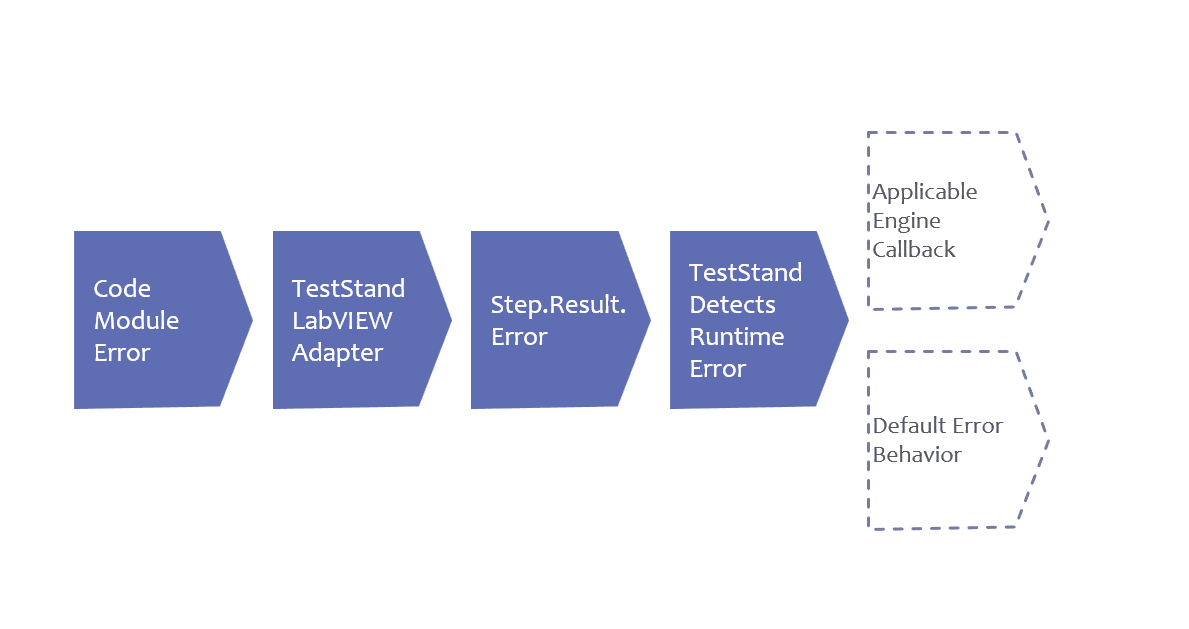
Derfor bør du som udvikler også være ekstra påpasselig med, hvordan du laver din systemfejlhåndtering i kodemodulet, og hvilke systemfejl du leverer videre til den kaldende sekvens. Det er i den sammenhæng også vigtigt at holde sig for øje, hvordan en fejl propagerer gennem TestStands eksekvering af en test, som kan ses på figur 2 herunder.
Hvorfor bør du oversætte dine fejlkoder?
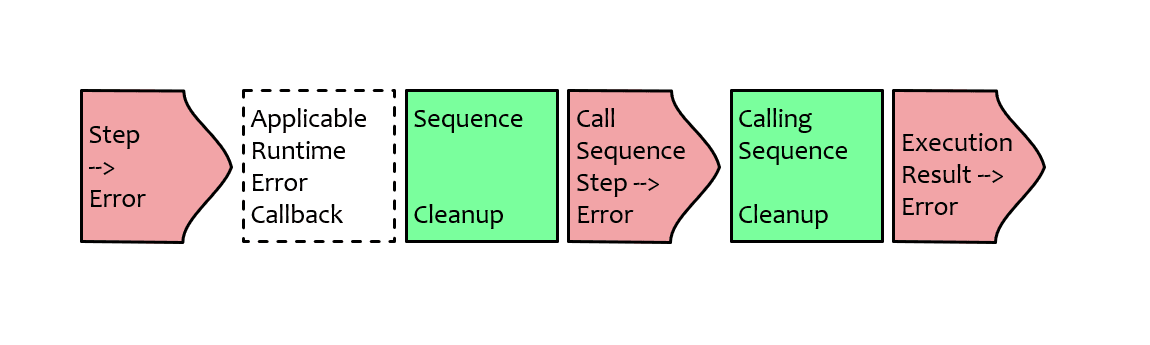
Når en fejl opstår i et step i en undersekvens, anvender TestStand de tilgængelige og passende callbacks, som udvikleren har konfigureret. Derefter gennemføres oprydningsstepgruppen for den givne undersekvens. Hvis fejlen stadig er aktiv efter de respektive runtime error callbacks, rapporterer sekvenskaldet i den kaldende sekvens, at der er sket en fejl, og denne skifter til sin oprydningsstepgruppe. Sådan fortsætter det, indtil TestStand når ud til det øverste niveau, hvor den kan melde, at testen oplevede en fejl.
Fejlhåndtering på lavest mulige programniveau
Ansvaret for fejlhåndtering bør placeres på det lavest mulige programniveau, hvor man har den nødvendige viden til at håndtere den givne fejl. Inden for softwareudvikling bruger man princippet om ”Single Responsibility”, hvor hver komponent kun har ansvar for sit eget område. Dette gælder også inden for testsystemsudvikling. Et kodemodul skal kun håndtere de ansvarsområder, som den er designet til som fx at forsøge at reetablere forbindelsen til en strømforsyning. Kodemodulet skal altså ikke tage stilling til, om DUT skal fejle, hvis forbindelsen fejler, da dette ansvar hører til i det kaldende step i TestStand.
I de fleste testsystemer, der er baseret på TestStand, anvendes de indbyggede procesmodeller, og de er designet til at inkludere logiske placeringer til fejlhåndtering. I alle modellerne er der indbygget undersekvenser eller callbacks, som kan overskrives for den enkelte testsekvens eller specifikt for teststationen. Der er med andre ord taget højde for, hvor din fejlhåndteringskode skal placeres, og hvornår den bliver kaldt i processen. På tværs af processmodeller virker det endnu bedre. Du kan finde listen over de indbyggede callbacks her.
Som du nok har lagt mærke til, findes der mindst tre forskellige steder at overskrive TestStands opførsel, når det kommer til fejl:
- SequenceFilePostStepRuntimeError
- ProcessModelPostStepRuntimeError
- StationPostStepRuntimeError
Fejlene bliver kaldt i forskellige konteksts, og det er meget vigtigt at forstå, hvordan de hænger sammen.
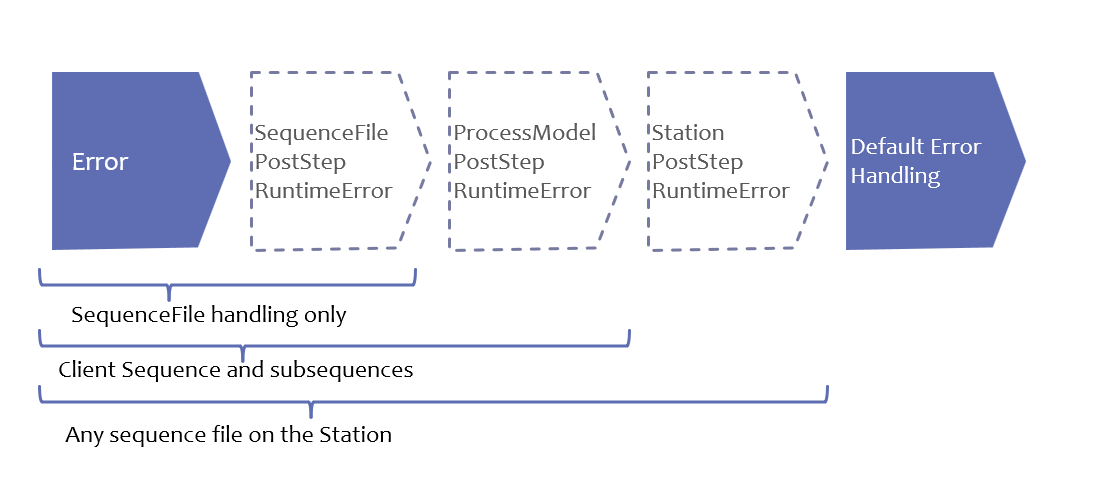
Hvis du overskriver en PostStepRuntimeError callback på sekvensniveau, eksekveres denne kun for det fejlende step i den specifikke sekvensfil, hvor callbacken er defineret. PostStepRuntimeError håndterer ikke fejl, som sker i en ekstern sekvens i en anden fil gennem et sekvenskald af en given sekvens. Men hvis du overskriver denne og ProcessModelPostStepRuntimeError, vil den inkludere håndtering af den eksterne sekvens. Sammenhængen kan ses på figur 2, hvor hver af de mulige callbacks interagerer med hinanden. Hvis du overskriver en enkelt callback, er det ret simpelt, men det skal siges, at TestStand de respektive callbacks, jo flere du overskriver.
De systemfejl, som håndteres i testsekvensen, kan muligvis afhjælpes ved at gentage handlingen, der skabte fejlen. Hvis testen antager, at DUT er i en given tilstand, kan testen forsøge at få DUT over i den nødvendige tilstand igen. Men der kan være andre problemer ukendt for testsystemet, som skaber problemet, hvor en gentagelse ikke afhjælper problemet, f.eks. en korrupt konfigurationsfil. Fejler dette kan testsystemet afslutte testen og testsystemet på en sikker måde ved at gennemføre de respektive cleanup steps, hvor udvikleren har defineret de nødvendige operationer, som bringer systemet til en kendt tilstand.
Gør din fejlhåndtering bedre over tid
I slutningen af 1940’erne og starten af 1950’erne så Toyota Production System dagens lys og mange af de problematikker, som det løste, er stadig gældende i dag. Her havde alle medarbejdere muligheden for at stoppe produktionen når de identificerede en fejl der kunne elimineres. Det er vigtigt, at operatøren og ikke mindst hans leder er klar over, at hver af disse ovenstående dialoger, som bliver fjernet, er en god ting for firmaet. Det er vigtigt, at man ikke overser dette i nutiden, selvom alle har travlt, og har KPI-er og metrikker at leve op til.
Testudviklerne bør derfor være lydhøre overfor at udbedre fejlhåndteringen, så fejlene undgås, og kan de ikke undgås, så bør der implementeres tiltag, der fjerner behovet for operatørens viden og erfaring. Fejlende netværkskommunikation kommer af en grund. Det kunne i kodemodulet være håndteret ved, at den selv genstarter forbindelsen frem for at sende en fejl videre til omverdenen. Hvis genoprettelsen så ikke virker, er det ok at fejlmelde netværksforbindelsen til DUT og afslutte testen på sikker vis. Dette håndteres helt og aldeles i sekvensen, når denne har prøvet at afhjælpe fejlen.
Hvis gentagelsen logges i Teststand, kan testrapporten afspejle, at der var et fejlet forsøg på genoprettelse af forbindelse inden DUT, og derfor er DUT blevet fejlmeldt efterfølgende. Når det er sagt, kan der være mange grunde til, hvorfor netværksforbindelsen ikke længere virker, såsom:
- Skader på kablet eller stikket til netværket
- Slid af elektriske kontakter på fiksturet
- IT har lanceret en ny konfiguration til den switch/router, hvor netværkskablet føres igennem
- Strømudfald på switch eller router
- Og mange andre problemer…
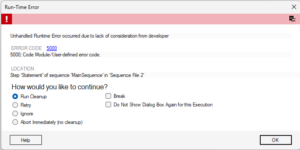
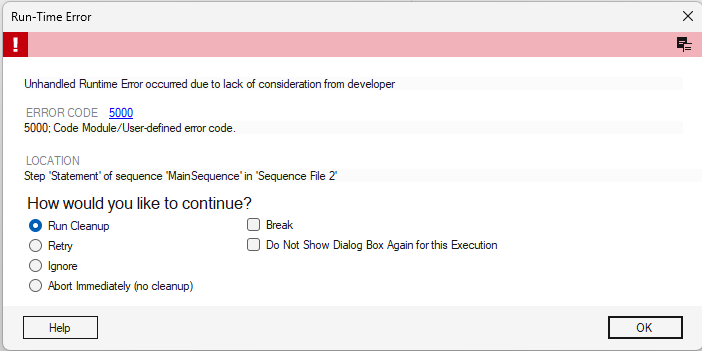
Dette er ikke det samme som at vise operatøren dialogen, se figur 4, om at tage stilling til næste skridt. Strategien er allerede lagt på forhånd, og der er et ekstra forsøg til at forbinde til DUT, og håndteringen er således taget af operatørens skuldre. Hvis man antager, at operatøren ikke er bekendt med Teststand, kan det være svært at forstå konsekvenserne af de optioner, som man kan vælge imellem i dialogen på figur 4. Operatøren er muligvis ikke bekendt med, hvad ”Cleanup” betyder, og hvorfor det er vigtigt i TestStand øjemed.
Derudover er det blandt andet disse dialoger og den deraf følgende manglende fejlhåndtering, som saboterer at have en høj takttid på et testsystem. Som produktionschef kan man hurtigt forestille sig, at den enkelte operatør, som skal håndtere dialogen, muligvis skal konferere med en kollega for at tage den rigtige beslutning: Unødig spildtid, som man kunne have sparet. Den tid, som det tager at fikse at et testsystem skal lukke ned, bliver hurtigt tjent hjem, når dette scenarie bliver løst. Det vigtigste er, at der er en åben kommunikation mellem operatøren og udvikleren. På samme måde som produktet udvikler sig over tiden, så bør testsystemet og dermed også fejlhåndteringen udvikle sig tilsvarende
God fejlhåndtering handler om at lade testsystemet tage ansvar for fejlene – ikke operatøren. Det skaber færre afbrydelser og en mere effektiv produktion.
– LabVIEW Champion, Jesper Kjær Sørensen, GPower